GWAS 全链路
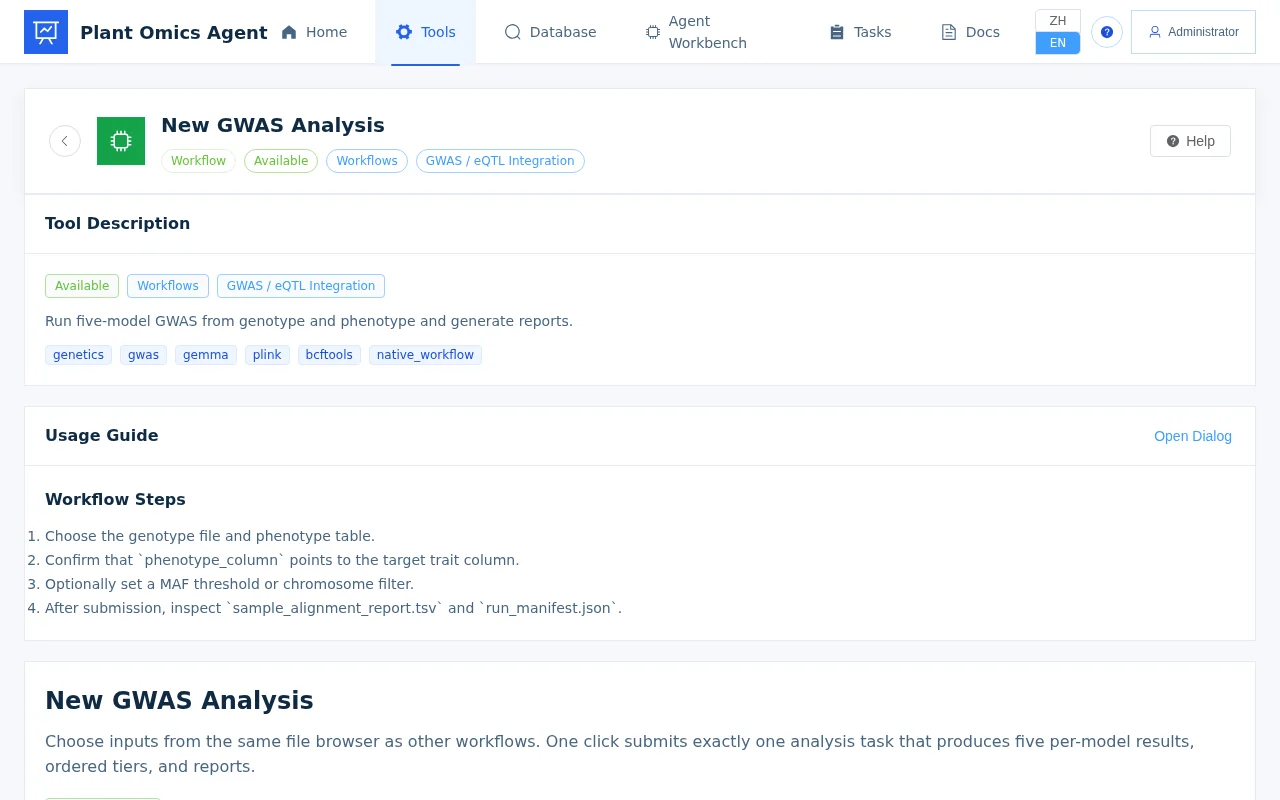
GWAS(全基因组关联分析)用于在自然群体中定位与目标表型关联的遗传位点。平台的 GWAS 链路已产品化为前端一页式表单:在工具目录打开 GWAS 工作流、填一次表单,即可跑完从质控、五模型关联到注释、绘图与报告交付的完整流程,无需逐个工具串联。
适用场景
- 自然群体 / 关联群体的数量性状定位(株高、产量、抗性等);
- 质量性状与驯化相关的选择信号分析;
- 关联位点下游候选基因的证据收集(可衔接数据库查证与可选的 GO/KEGG 富集)。
输入与表单
| 输入 | 格式 | 说明 |
|---|---|---|
| 基因型 | VCF 单文件,或 PLINK BED 三件套(.bed/.bim/.fam) | 二选一;缺 BED 时链路自动从 VCF 转换为规范 PLINK BED |
| 表型表 | 表格(CSV/TSV) | 一列样本 ID(与基因型样本名一致)+ 一列或多列表型值;表单中性状列从下拉列表选择 |
表单中还需选择参考版本:B73 v4 / B73 v5 / Others(其他物种或自备参考),该选择决定后续效应注释与富集所用的背景。
提交前意图审查:点击提交后、任务进入队列前,平台会先展示一次意图确认,核验所选的基因型文件、表型文件、性状列与参考版本档位是否匹配——选错文件或档位不一致在这一步即可退回修改,不会带着错误输入起跑。
分析链路
QC(缺失率 / MAF / 样本)
→ 亲缘关系矩阵(kinship)+ PCA
→ 五模型一次提交(GEMMA LMM / LM + rMVP GLM / MLM / FarmCPU)
→ 显著性梯度多档阈值(由严到宽)
→ SnpEff 效应注释(v5 默认 / v3 显式)
→ CMplot 出版级曼哈顿图 / QQ 图
→ 自包含 HTML 汇总报告 + 项目交付 ZIP
→ 同版本地基因注释 + 可选 GO/KEGG 富集(B73v4/v5 双背景)
| 阶段 | 做什么 | 你能看到什么 |
|---|---|---|
| QC | 样本 / 位点缺失率与 MAF 过滤 | QC 指标与过滤前后的位点、样本规模 |
| 群体结构 | 构建亲缘关系矩阵并做 PCA | kinship 矩阵与 PCA 图,供协变量决策 |
| 关联 | 五模型一次提交 | 各模型关联统计表,结果互为参照 |
| 显著性梯度 | 多档阈值(由严到宽)分档汇总 | 同一结果在不同严格程度下的位点集合对照 |
| 注释 | SnpEff 效应注释 | 位点的基因区 / 同义 / 错义等效应分类 |
| 绘图 | CMplot 曼哈顿图 / QQ 图 | 出版级图形文件 |
| 报告与交付 | 自包含 HTML 报告 + 交付 ZIP | 见下文「报告与交付」 |
| 基因注释与富集 | 同版本地基因注释 + 可选富集 | 位点邻近基因注释与 GO/KEGG 结果 |
模型与阈值
五模型覆盖单一位点与多位点两类方法,一次提交并行跑完:
| 模型 | 家族 | 特点 |
|---|---|---|
| GEMMA LMM | 单一位点混合线性模型 | kinship 校正群体结构的主线模型 |
| GEMMA LM | 单一位点线性模型 | 不含 kinship,作对照参照 |
| rMVP GLM | 广义线性模型 | 广义模型基线 |
| rMVP MLM | 混合线性模型 | kinship 校正 |
| FarmCPU | 多位点模型 | 逐步固定效应校正,补充单一位点模型的遗漏 |
显著性以多档梯度阈值呈现(由严到宽):同一份关联结果在多个严格程度下分档汇总,便于对照”哪些位点在严档仍然成立”,而不是被单一阈值锁死视角。
探索出口
对已完成的关联结果,平台提供两个出口:
- B1 只读画像:多档阈值显著性概览——只读地汇总各档阈值下的位点数量与区间分布,不改动任何结果;
- B2 有界自动探索:在预设预算上限内自动做分档探索(计算量与输出规模有界)。探索结果带校准状态诚实标注:未完成校准的结果只标注为”未校准”,不宣称发现。
注释与富集
- 效应注释:SnpEff 对关联位点做效应注释(基因区 / 内含子 / 同义 / 错义等),默认使用 v5 注释库,需要 v3 时在表单中显式选择;
- 本地基因注释:与所选参考版本一致的同版本地基因注释,保证”位点 → 邻近基因”的对应关系与参考版本一致;
- 可选富集:对候选基因集可顺跑 GO/KEGG 富集,提供 B73v4/v5 双背景,与上游注释版本保持一致。
报告与交付
任务完成后交付两件套:
- 自包含 HTML 汇总报告:单文件、浏览器直接打开,汇总 QC 指标、五模型概览、显著性梯度分档与全部图形;
- 项目交付 ZIP:关联统计表、注释表、出版级图形、日志与中间文件统一打包,解压即用。
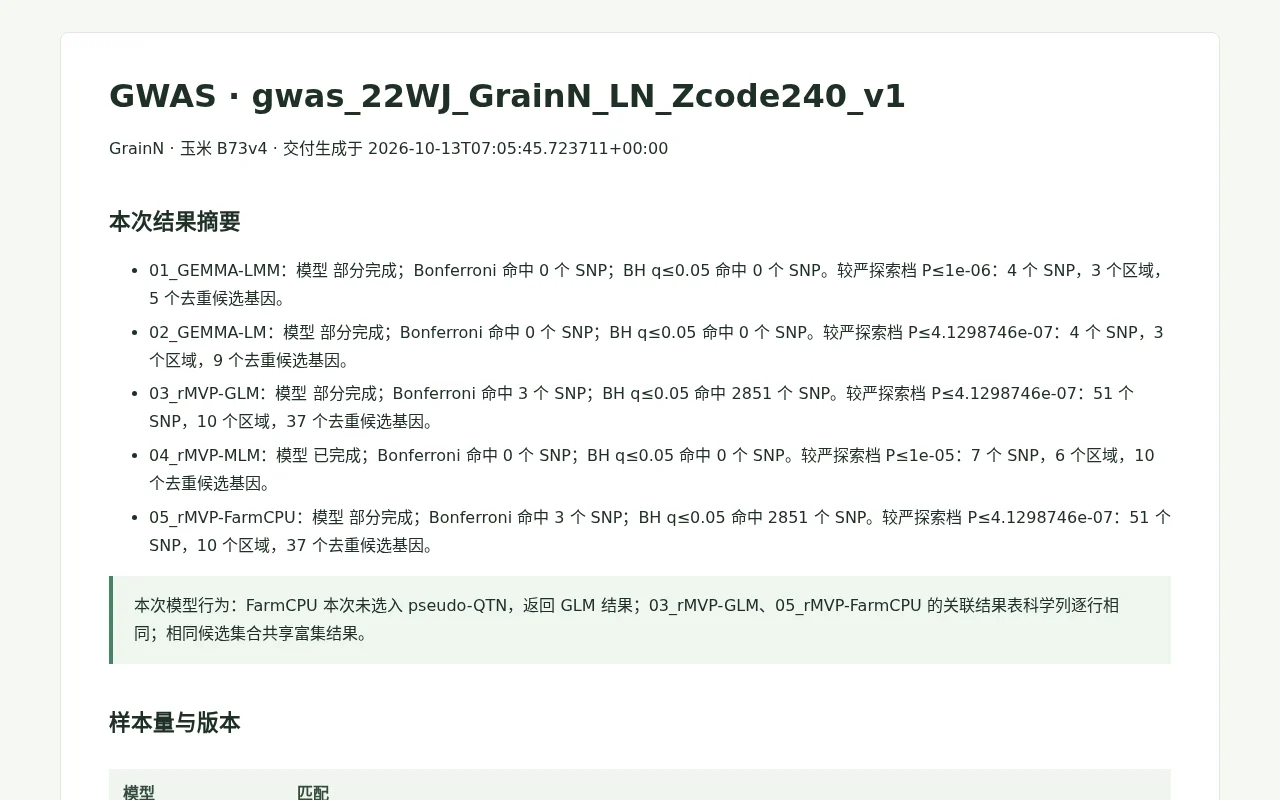
报告里的两张核心图这样读:
| 图 | 怎么看 |
|---|---|
| QQ 图 | 观测 p 值与期望的对比。中段贴合对角线、尾部上翘属正常信号;整体膨胀提示群体结构未校正充分 |
| 曼哈顿图 | 每条染色体上的 -log10(p),叠加多档显著性阈值线;在严档仍超过阈值线的位点是优先关注的候选 |
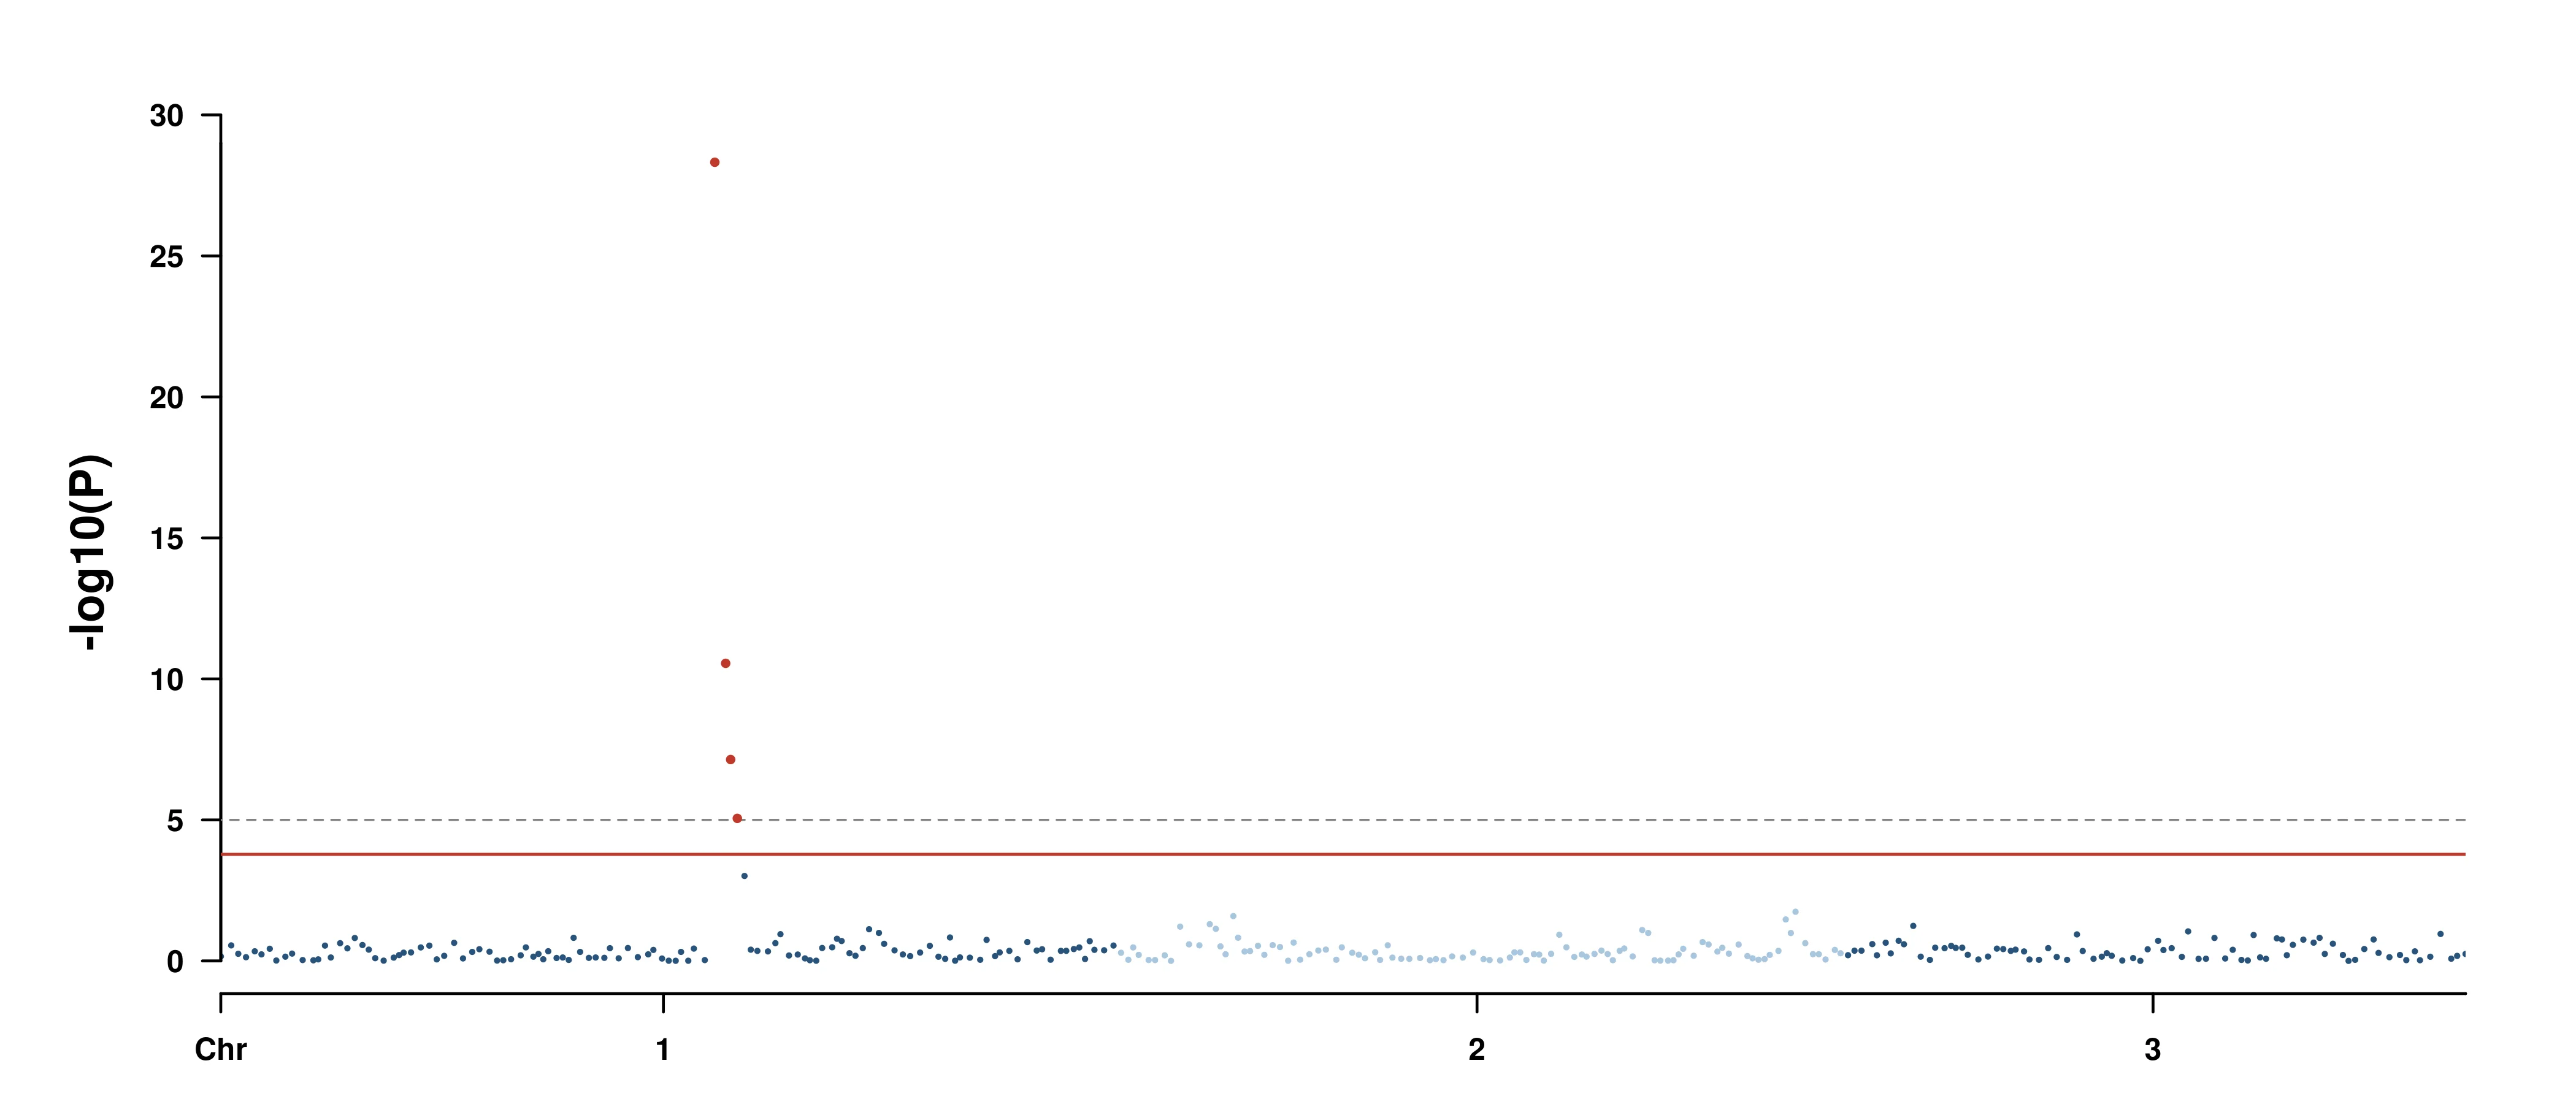
规模参考(真实数据端到端验证,仅运行规模事实):全基因组数据已完成两次端到端验证,其中一次全流程重跑约 88 分钟;五模型全部完成,各模型有效 P 行 2,421,381;交付包含 234 个文件、约 458MB。
事后探索(posthoc)
已有 GWAS 关联结果(本平台产出或外部结果)可以直接提交事后探索:在工具目录打开 gwas_posthoc,指定关联结果文件与探索档位,即可对既有结果做分档探索,不必重跑关联。
注意事项
- 样本量:GWAS 检验位点多,样本量不足会明显降低功效;群体类分析建议至少上百个样本,稀有变异功效更差;
- 群体结构:材料若含亚群混合,务必使用 kinship + 混合模型并酌情把 PCA 轴放入协变量,否则会大量假阳性——QQ 图整体膨胀是典型信号;
- MAF 阈值:QC 时按样本量设定合理 MAF(常见 0.05 或更严),过低频率的位点统计功效低且易假阳性;
- 表型质量:表型最好有多环境重复或 BLUP 值,单环境噪声会稀释关联信号;
- 参考一致性:基因型的参考版本要与后续注释、富集一致(如玉米 B73 v4 / v5 勿混用)。